







 选型指南


 品牌评测

随着人工智能技术的飞速发展,深度学习能力成为了推动其不断前进的核心引擎之一。在这一大背景下,大模型的崛起成为了人工智能发展到一定阶段的重要标志。AI智能质检,作为企业部门不可或缺的工具,已经展现出了强大的潜力和价值。
一、如何使用大模型进行智能质检
1.数据收集:
收集大量的对话数据,这些数据可以来自电话录音、聊天记录、电子邮件等。确保数据的多样性和代表性,以涵盖各种可能的对话场景和问题。
2.数据预处理:
对收集到的数据进行清洗,去除噪音和无关信息。将数据转化为可分析的文本格式,如TXT、CSV等。对数据进行标注,以便后续的训练和评估。
二、中关村科金得助智能质检的核心优势及结合建议
多模态质检能力
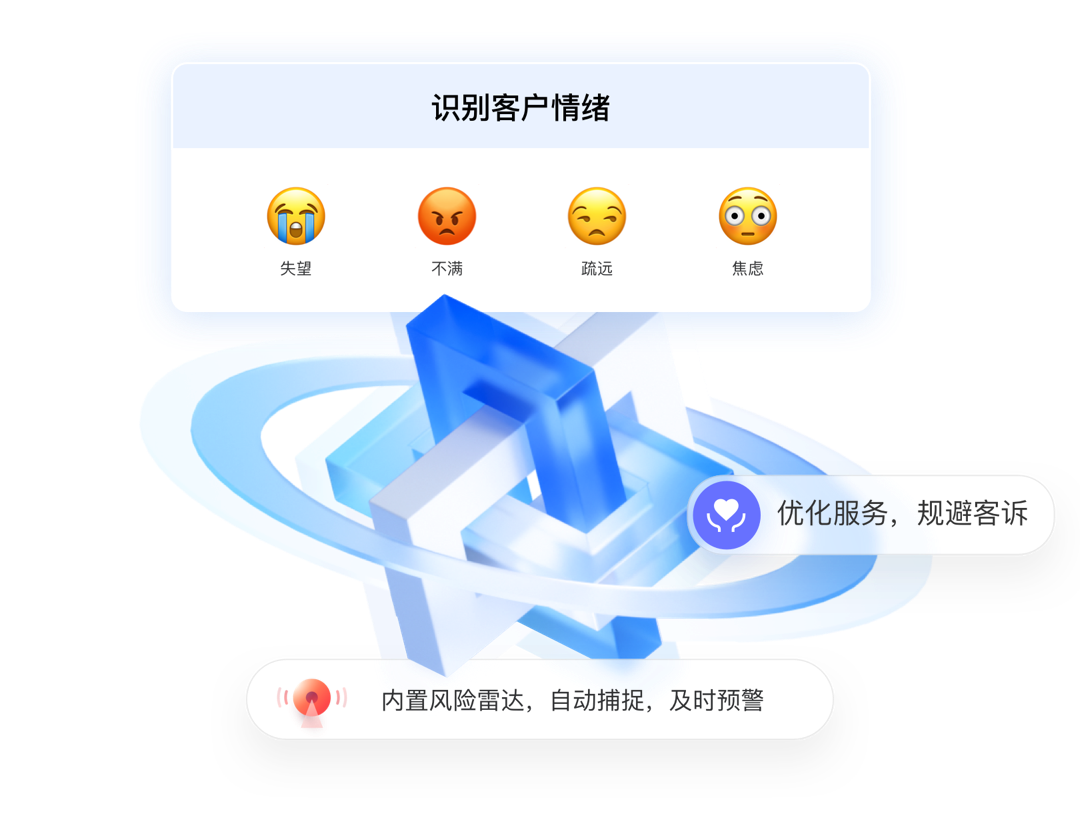
除文本外,支持语音、视频(如表情、肢体语言)的实时分析,增强情感识别和客户意图理解的准确性,尤其适用于电话销售或视频客服场景。
结合建议:在“数据收集与预处理”阶段,集成多模态数据源,利用得助的ASR(语音识别)和NLP技术统一处理。
行业预训练模型
得助提供金融、电商等行业的预训练质检模型,内置行业术语库和合规规则(如金融话术合规性检查),减少企业从零训练的成本。
结合建议:在“选择大模型”阶段,直接调用行业适配模型,仅需微调而非全量训练。
实时质检与打断机制
支持实时检测到违规话术(如过度承诺)时主动提醒坐席,而非事后复盘,提升服务即时性。
结合建议:在“实时分析”环节,配置得助的实时干预API,触发弹窗或语音提示。
三、大模型智能质检关键流程优化建议
1.模型训练与优化
数据标注效率:利用得助的“智能标注辅助工具”,通过预标注减少人工标注工作量,加速训练数据准备。
冷启动方案:若企业无历史数据,可使用得助的仿真对话生成功能,合成训练数据。
2.质检标准设定
内置规则库:直接调用得助的1000+预置质检规则(如“未报工号”“敏感词触发”),快速搭建基础标准。
动态阈值调整:通过得助的A/B测试功能,对比不同阈值(如语速、静默时长)对客户满意度的影响,优化指标。
3.持续优化与迭代
自动根因分析:得助的“问题聚类”功能可自动归类高频问题(如60%投诉源于物流延迟),指导流程优化。
闭环反馈:将质检结果同步至得助的“智能培训系统”,自动生成针对性课程(如产品知识薄弱人员推送课程)。
四、实施注意事项
1.混合质检模式
复杂场景(如客户情绪激烈时)启用“AI初筛+人工复核”,通过的助工单系统分配可疑录音给质检员。
2.模型偏见监控
定期使用得助的“公平性检测工具”评估模型是否存在地域口音歧视等偏差。
3.ROI量化
利用得助的“质检效能看板”跟踪指标(如投诉率下降百分比、人力节省时长),明确AI投入产出比。
五、中关村科金ai智能质检大模型免费预约演示

中关村科金的得助智能质检方案可大幅加速企业智能质检落地,尤其在多模态处理、行业适配性、实时干预方面表现突出。企业实施时需聚焦三点:优先复用预置模型和规则,减少开发周期;通过实时反馈与培训形成“质检-改进”闭环;定期结合业务需求迭代模型,避免规则僵化。


 目录
 精选案例




 相关产品推荐
 热门文章
 专题推荐