







 选型指南


 品牌评测

OCR(Optical Character Recognition),即光学字符识别,是一种将图像中的文字转换成可编辑文本的技术。这项技术广泛应用于文档数字化、自动数据录入、图书扫描、车牌识别等多个领域。
OCR技术的基本工作流程通常包括以下几个步骤:
1. 图像预处理:对扫描或拍摄的图像进行去噪、二值化、倾斜校正等预处理操作,以提高识别的准确性。
2. 文字定位:在图像中检测文字区域的位置,确定文字的边界。
3. 文字分割:将检测到的文字区域分割成单个字符。
4. 字符识别:对分割后的单个字符进行识别,将其转换为计算机可识别的字符编码。
5. 后处理:对识别结果进行校对、格式化等处理,以提高最终文本的质量。

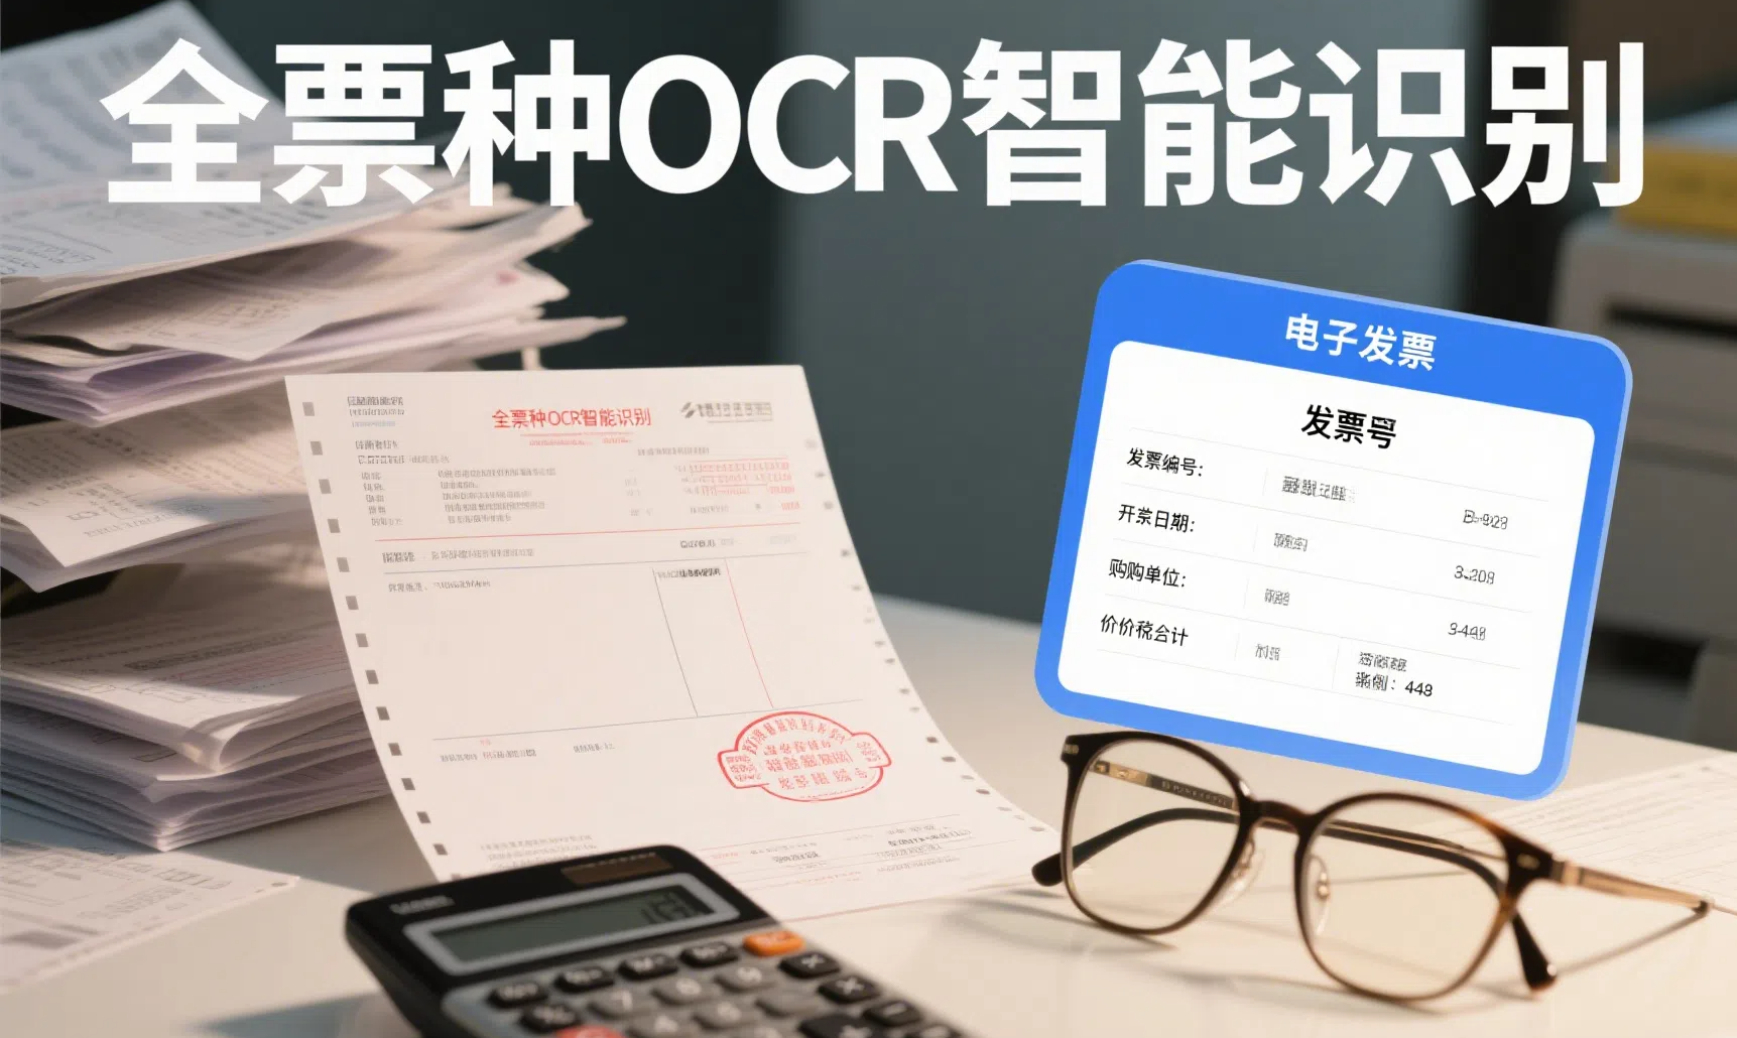
目前,市场上有许多OCR软件和API服务,它们提供了不同的功能和精度,适用于不同的应用场景。例如,得助OCR平台是一站式全流程文字识别产品,可识别海量票据信息并批量导出,还可自定义文字识别模型,让企业掌握关键技术,识别准确率高达95%以上。
得助OCR平台适用于各类票据、合同文档、身份验证、交通等80+文字识别场景,提升企业办公效率,推动企业数字化转型发展。
在中国,随着人工智能技术的发展,许多科技公司也推出了自己的OCR产品和服务,这些服务通常集成了深度学习技术,能够提供更高的识别准确率和更快的处理速度。在使用OCR技术时,需要注意版权和隐私保护问题,确保在合法合规的范围内使用。同时,对于一些特殊字体或格式复杂的文档,可能需要进行特定的优化或定制开发,以达到更好的识别效果。


 目录
 精选案例


 相关产品推荐
 热门文章
 专题推荐